本記事は、私たちDBRE(Database Reliability Engineering)チームが2026年3月末までに行った改善を紹介する3つの記事の3つ目(最終回)です。
1つ目の記事「メルカリにおけるTiDB改善の取り組み:IN句内100万件クエリへの対応」では、IN句に多数の要素を含むクエリがTiDBクラスタ全体のレイテンシを悪化させた事例を紹介しました。2つ目の記事「メルカリにおけるTiDB改善の取り組み:リソース制御・リージョンサイズ・プランキャッシュ編」では、リソースグループの不具合対応、リージョンサイズの調整、プランキャッシュの検討、In Memory Engineの導入という、パラメータや機能面の改善を紹介しました。
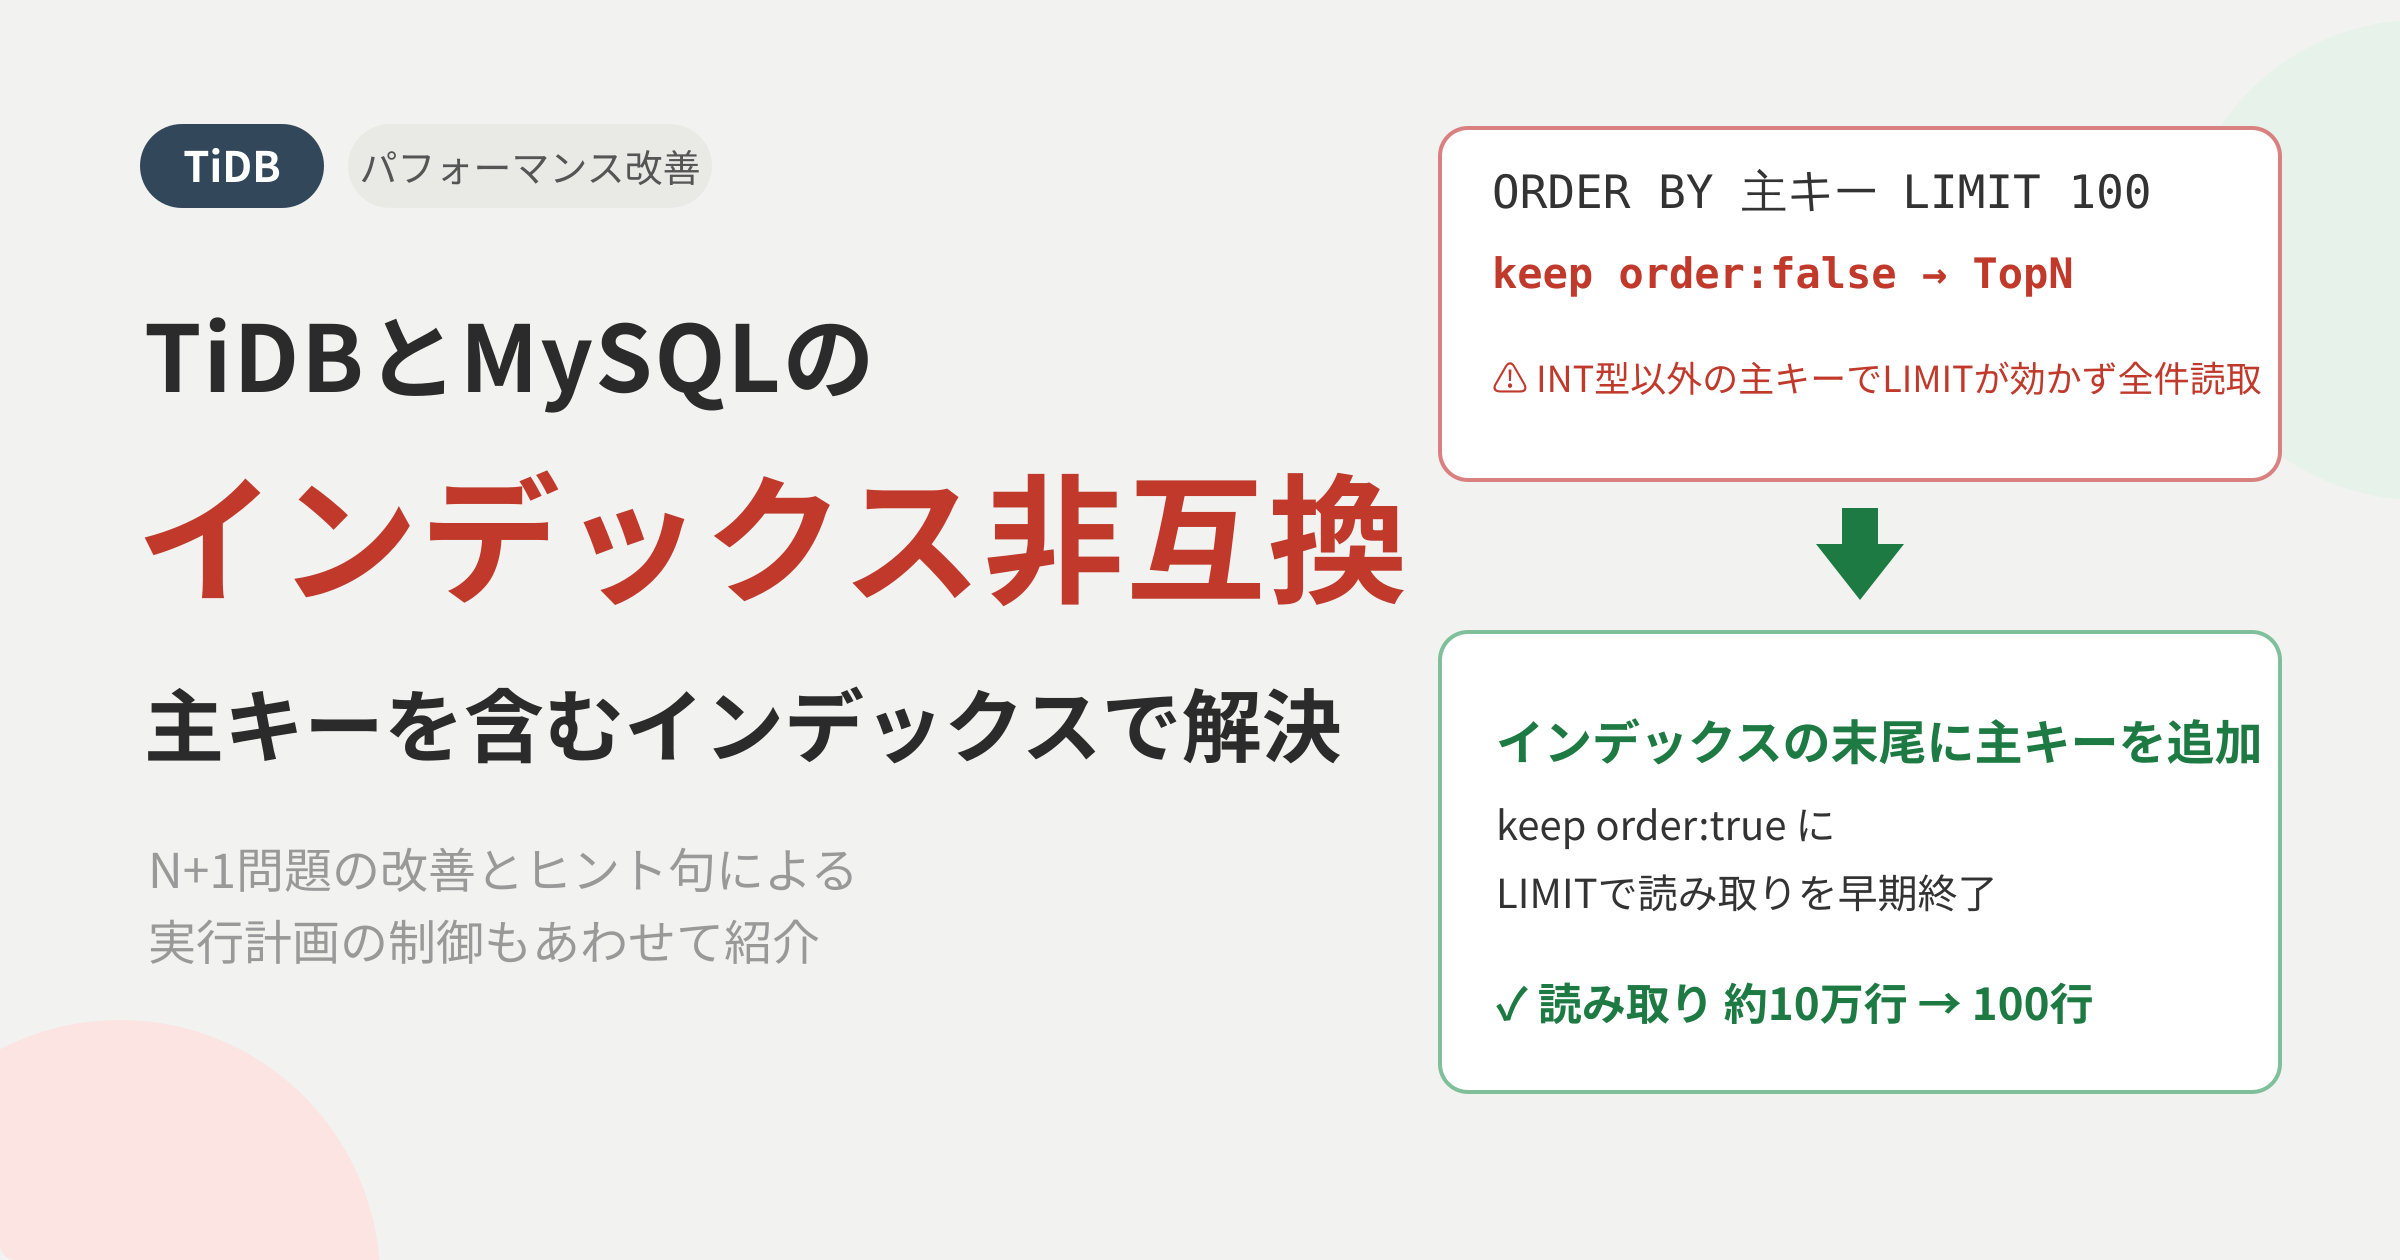
最終回となる本記事の中心は、TiDBとMySQLにおけるインデックス挙動の非互換への対応です。クラスタ化された複合主キーや非整数主キーを持つテーブルにおいて、主キーのORDER BYがインデックス順として認識されないという挙動の違いと、インデックス追加による対処を、実行計画を交えて詳しく解説します。
あわせて、移行と並行して実施したより一般的な改善として、N+1問題の改善とヒント句による実行計画の制御にもふれます。これらはTiDBに限らずデータベース一般に見られるごく一般的な問題ですが、分散データベースへの移行を境に顕在化しやすいテーマです。MySQLからTiDBへの移行を検討している方の参考になれば幸いです。
インデックス非互換への対応(インデックス追加)
まず、本記事の中心であるインデックス非互換への対応を紹介します。対処自体はインデックス追加というよくある手段ですが、その背景にはTiDBの実行計画に関する固有の挙動がありました。
TiDB移行にあたり、特定のクエリではTiDBとMySQLで同一のインデックスに対する挙動の違いを確認したため、追加のインデックスを作成する必要がありました。
- 条件: クラスタ化された複合キーまたは非整数の主キー(common handle)を持つテーブルで、非ユニークなセカンダリインデックスを使ったとき
- 発生事象: 主キーカラムのORDER BYがインデックスの順として認識されずTopNになる
- 必要な対応: 主キー順のソートが必要な場合、インデックスの末尾に主キーを含める
本件は直感に反する挙動であったため、コントリビュートして修正しようと調査していたところ、すでに最新のmasterでは改修されていました(pingcap/tidb#66645)。なお、8.5系への取り込み(pingcap/tidb#67107)は本記事執筆時点ではまだマージされておらず、LTS(Long-Term Support)の最新バージョンであるv8.5.7には含まれていません。
本事象の再現例は下記のissueにまとめられています。
https://github.com/pingcap/tidb/issues/66644
この挙動が実行計画にどう現れるかを、上記issueに記載されている再現例を用いて補足します。主キーの型だけが異なる2つのテーブルを比較すると差がはっきりします。
CREATE TABLE t1 (
a int, b int, c int,
PRIMARY KEY (a),        -- int 1カラム → int handle
KEY ic (c)
);
-- こちらのケースで非互換になる
CREATE TABLE t2 (
a1 varchar(64), a2 int, b int, c int,
PRIMARY KEY (a1, a2),   -- 複合キー → common handle
KEY ic (c)
);
SELECT * FROM t1 WHERE c = 0 ORDER BY a LIMIT 100;
SELECT * FROM t2 USE INDEX (ic) WHERE c = 0 ORDER BY a1, a2 LIMIT 100;
ここで出てくるcommon handleについて簡単に補足します。TiDBは行のIDとしてhandleと呼ばれる値を持ち、テーブルの実データはこのhandleをキーとして格納されます。主キーが単一のint型カラムであれば、その値がそのまま64bit整数のhandleとなり、これをint handleと呼びます。一方、複合主キーや文字列の主キーでは、主キーの全カラムをエンコードしたバイト列がhandleとなり、こちらをcommon handleと呼びます。どちらの場合もセカンダリインデックスのエントリに主キーカラムが含まれる点は共通で、InnoDBのクラスタ化インデックスに相当する仕組みです。なおこの使い分けは主キーがクラスタ化されている場合の話で、TiDBの既定ではクラスタ化されます。
https://docs.pingcap.com/tidb/stable/clustered-indexes/
やりたいことはどちらも「c = 0 の行を主キー順に並べて先頭100行」です。インデックス ic の物理的な並びはどちらのテーブルでも(c, 主キーカラム)なので、c = 0 に絞ればその中は主キー順に並んでいます。つまり本来はどちらも「インデックスを順に読んで100行で止める」だけで済みます。
int主キー(int handle)のt1では、実際にその計画が選ばれます。
IndexLookUp_37                 estRows=100    root       limit embedded(offset:0, count:100)
├─Limit_36(Build)              estRows=100    cop[tikv]  offset:0, count:100
│ └─IndexRangeScan_34          estRows=100    cop[tikv]  index:ic(c)  range:[0,0], keep order:true
└─TableRowIDScan_35(Probe)     estRows=100    cop[tikv]  keep order:false
IndexRangeScan の keep order:true は、この演算子が出力順を保証することを示します。インデックスの物理順(c, a)がそのまま ORDER BY a を満たすため、後段でソートする必要がありません。coprocessor側の Limit が100件で読み取りを打ち切り、それが IndexLookUp に limit embedded として埋め込まれるので、インデックススキャン自体が100件で停止します。テーブル本体を引く TableRowIDScan も、その100行に対してだけ実行されます。ソート演算子は1つも現れません。
一方、int以外の主キー(common handle)のt2では改修前は次の計画になります。
TopN_10                          estRows=100        root       t2.a1, t2.a2, offset:0, count:100
└─IndexLookUp_19                 estRows=100        root
├─TopN_18(Build)               estRows=100        cop[tikv]  t2.a1, t2.a2, offset:0, count:100
│ └─IndexRangeScan_16          estRows=100100.60  cop[tikv]  index:ic(c)  range:[0,0], keep order:false
└─TableRowIDScan_17(Probe)     estRows=100        cop[tikv]  keep order:false
こちらは keep order:false となっており、オプティマイザが「このインデックスは a1, a2 の順序を提供しない」と判断しています。順序を使えないため LIMIT で読み取りを早期に打ち切る根拠がなくなり、c = 0 に一致するインデックスエントリを全件読むことになります。estRows=100100.60 がその見積りです。読み終わったあとに TopN で(a1, a2)でソートして上位100件を残す形になります。
TopN が2段あるのは、coprocessorのタスクがリージョン単位で並列実行されるため、TopN_18 の結果が「リージョンごとの上位100件」という部分結果にとどまり、それらをTiDB側の TopN_10 で束ねて全体の上位100件を確定させる必要があるからです。
差は次の3点に整理できます。
| int主キー(int handle, t1) / MySQL | 改修前のint以外の主キー(common handle, t2) | |
|---|---|---|
| 1. インデックススキャンの順序保証 | keep order:true。インデックスの物理順をそのまま結果順として使う |
keep order:false。順序を使えないため後段でソートが必須になる |
| 2. LIMITの扱い | Limit がcoprocessorにpush downされ、さらに IndexLookUp に埋め込まれる。100件で読み取り自体が止まる |
Limit が単独で残らず TopN に吸収される。TopN は全件読んでから上位Nを取るため、読み取りを早期に止められない |
| 3. 読み取りインデックスエントリ数 | 100 | c = 0 の一致行すべて。この例では見積り100,100 |
本質的なコストは3点目です。この差は LIMIT の値ではなく WHERE 条件に一致する行数に比例するため、条件に合致する行が多いテーブルほど大きくなります。逆に一致行が数百件程度しかないテーブルではほとんど差が出ません。加えてt2側には、t1に存在しないソートのコストが追加されます。この例ではa1がvarcharなので、比較はcollationを考慮したものになります。
MySQLでは、InnoDBのセカンダリインデックスが主キーの型に関係なく(c, a1, a2)順に並び、オプティマイザがそれを認識するため、c = 0 にシークしてインデックスを順方向に読み、100行で止まります。t1の計画と等価な実行になり、ソートは発生しません。つまり改修前のTiDBは、MySQLから主キーを複合キーや文字列キーに変えて移してきた場合に、同じSQL・同じインデックス構成でも実行の形が変わる状態でした。インデックスの末尾に主キーカラムを明示的に含め、この順序をオプティマイザに認識させることでMySQLと同等に動作します。
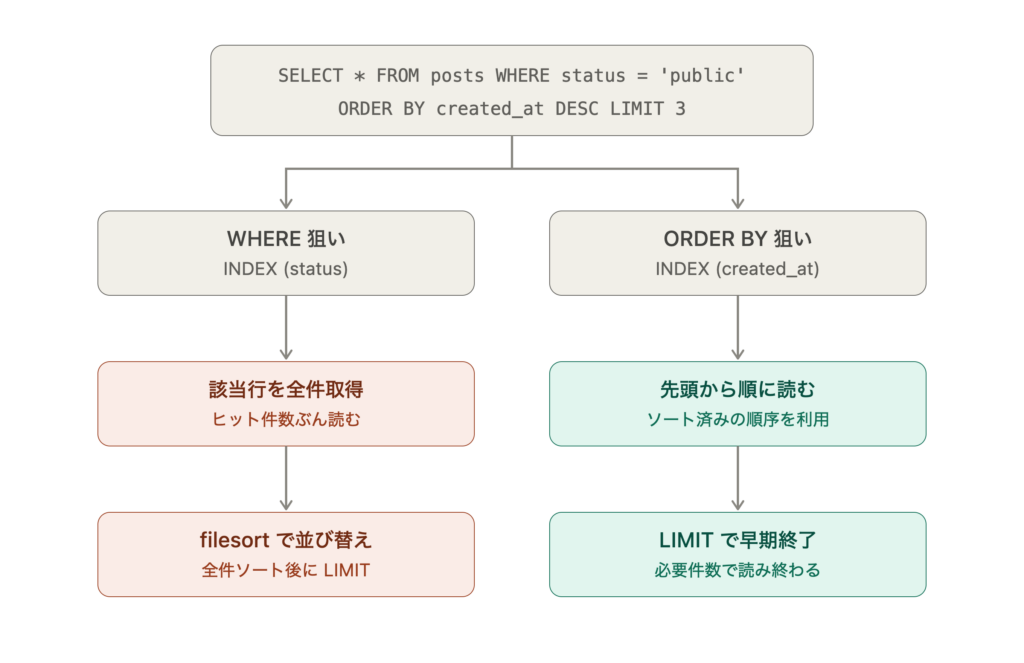
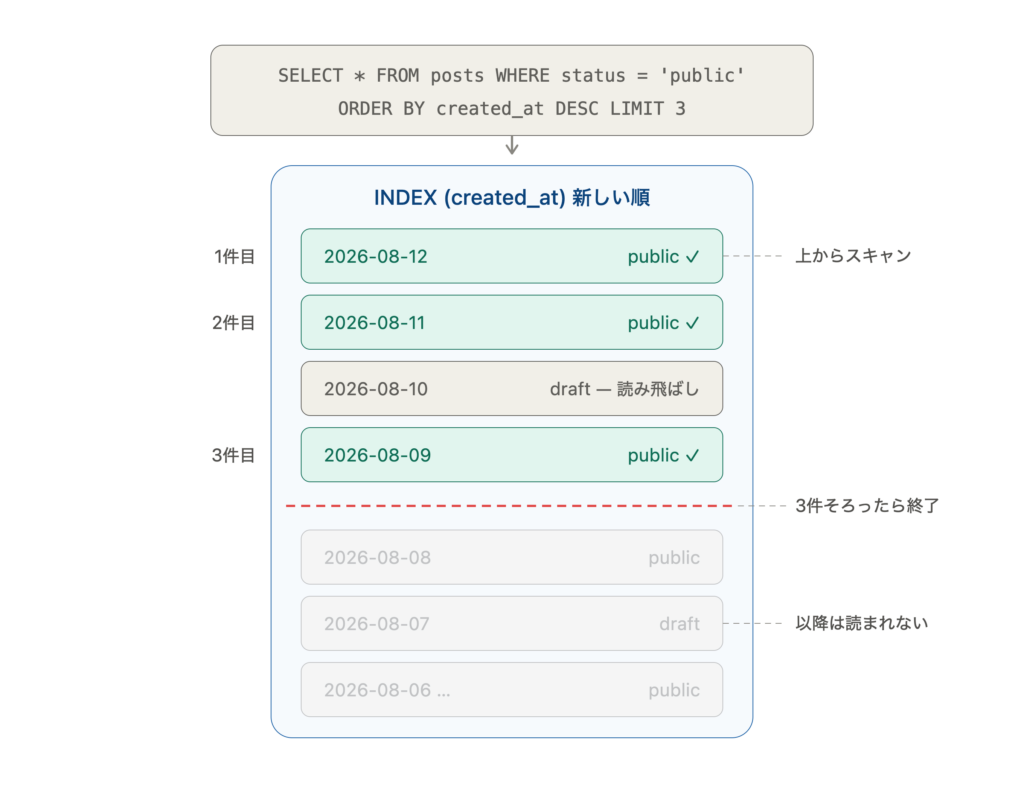
端的にこの問題をまとめると、メルカリでは「ORDER BY 狙いのインデックス」戦略が一定程度とられており、あるケースではTiDBとMySQLで主キーのソート処理が非互換のため、末尾に主キーを含めたインデックス作成という形でこれに対する対応を行いました。この対処は相当数のテーブルで必要になりました。同様のインデックス戦略をとっている場合、ORDER BY 主キー LIMIT を伴うクエリで本事象に遭遇する可能性があります。
本対処については、次の理由から対処は比較的容易な部類でしょう。
- DDL(Data Definition Language)がオンラインで高速
- Invisible Index が利用できる
- SQL Plan Management(SQL binding)が利用できる
その他の一般的な改善(N+1・ヒント句)
ここからは、インデックス非互換のようなTiDB固有の話題ではなく、データベース一般に広く見られる問題への対応を2点紹介します。N+1問題もヒント句による実行計画の制御も、それ自体はごく一般的な内容ですが、いずれもMySQLからTiDBへの移行を境に対応の必要性が顕在化しやすいため、あわせて共有します。
N+1の改善
N+1問題とは、1件の親データを取得したあと、関連するN件のデータを1件ずつ個別のクエリで取得してしまうアクセスパターンを指します。単一のAPI呼び出しの中で数百、数千回のデータベースアクセスが発生するため、クエリ1回あたりのレイテンシがそのまま応答時間に積み上がります。
MySQLと比較すると、TiDBは分散データベースである都合上、クエリ1回あたりのベースレイテンシがやや高くなります。このため、MySQLでは許容範囲に収まっていたN+1パターンが、TiDBへの切り替えを境に問題として顕在化することがあります。
このパターンについては、複数件をまとめて取得する形にクエリを集約するなど、開発チームと連携して一定数の改修を実施しました。
ヒント句による実行計画の制御
TiDBはMySQLと同様にオプティマイザヒントをサポートしており、/*+ ... */ 形式のコメントで結合アルゴリズムや使用インデックスなどを明示的に指定できます(Optimizer Hints)。統計情報に基づく自動選択が期待通りにならないクエリに対して、実行計画を安定させる手段として利用できます。
大量のデータを保持するテーブルを、複数回結合しているクエリでは、個別にヒント句をつけ、クエリを改善する必要がありました。全体の改善の中では、対象は少数のクエリに限られました。
可能であればそもそもMySQL(TiDB)で処理をするのではなく、BigQueryなどで動的にリソースを確保して処理をした方が望ましいケースが多くありましたが、アプリケーションの改修の都合でMySQL(TiDB)での処理を継続する必要があり、SQLの調整で対応しました。
なお、本記事で扱った内容より前の時期に実施した初期のパラメータ調整や検討については、下記の発表資料もあわせてご覧ください。
まとめ
本記事では、TiDBとMySQLのインデックス非互換への対応を中心に、N+1問題の改善やヒント句による実行計画の制御といった一般的なクエリ改善もあわせて紹介しました。最後に、それぞれの経験から得られた教訓を整理します。
中心トピックであるインデックス非互換への対応では、common handleを持つテーブルで主キー順のORDER BYがインデックス順として認識されないという、TiDBとMySQLの挙動の違いに対して、インデックスの末尾に主キーカラムを含めることで対応しました。TiDBはオンラインDDLが高速で、Invisible IndexやSQL Plan Managementといった機能も利用できるため、対処自体は比較的容易な部類です。なお本挙動は最新のmasterではすでに改修されています。
一般的な改善として紹介したN+1問題は、分散データベースであるTiDBではクエリ1回あたりのベースレイテンシがMySQLよりやや高いため、移行を境に顕在化しやすいパターンです。移行前に該当のアクセスパターンを洗い出し、複数件をまとめて取得する形にクエリを集約しておくことをおすすめします。
同じく一般的な手法であるヒント句は、統計情報に基づく実行計画の自動選択が期待通りにならないクエリに対して、実行計画を安定させる有効な手段です。ただし対象となるクエリは限られており、大量データの複雑な結合処理については、そもそもBigQueryなどの分析基盤へ処理を移すことも含めて検討する価値があります。
3つの記事を通じて、私たちDBREチームが2026年3月末までに行ったTiDBの改善の取り組みを紹介してきました。MySQLからTiDBへの移行や、TiDBの運用改善に取り組む方の参考になれば幸いです。
2026年4月以降もいくつかのアプリケーションの改修を含む改善をしており、こちらも別途ブログ記事で紹介します。ご期待ください。
おしらせ
最後に、現在メルカリでは、この記事の発行者の所属するDBREチームのEM(Engineering Manager)および、IC(Individual Contributor)を募集しています。
この記事を読んで興味を持たれた方は、その旨をお知らせください。
詳しくは以下をご覧ください。
- EM: https://apply.workable.com/mercari/j/7AD4EF9218/
- IC: https://apply.workable.com/mercari/j/ACD2689E9E/
また、メルカリにおけるTiDBやデータベース関連の取り組みについては、TiDB関連の記事一覧やデータベース関連の記事一覧もあわせてご覧ください。