本記事は、私たちDBRE(Database Reliability Engineering)チームが2026年3月末までに行った改善を紹介する3つの記事の2つ目です。
1つ目のブログ記事の「メルカリにおけるTiDB改善の取り組み:IN句内100万件クエリへの対応」では、IN句に多数の要素を含むクエリがTiDBクラスタ全体のレイテンシを悪化させた事例を紹介しました。
本記事では、下記の4点の対応や改善についてお伝えします。
- リソースグループの不具合に対する対応
- リージョンサイズ (coprocessor.region-split-size) の調整
- プランキャッシュの検討
- In Memory Engineの導入
これらの取り組みのうち、リージョンサイズの調整ではクラスタ全体のリージョン数を約10%削減し、TiKVのCPU負荷を最大約20%改善しました。また、In Memory Engineの導入では、0.5〜1.5秒かかっていたクエリのレイテンシを0.1秒程度まで短縮しています。一方で、プランキャッシュのようにワークロードによっては期待した効果が得られず、設定を見直した事例もありました。本記事では成果だけでなく、その判断に至る過程もあわせて紹介します。
リソースグループの不具合対応
まず、1つ目の取り組みとして、リソースグループの不具合への対応を紹介します。メルカリでは各ユーザーのリソース利用量の把握および、リソース利用量の制限を目的として、リソースグループの機能を利用しています。
https://engineering.mercari.com/blog/entry/20251211-3846ed440d/
このリソースグループの利用時に想定外にリソース利用量が制限され、高負荷になる、という事象に遭遇しました。私たちが観測した事象は、TiKVのCPUが高負荷になり、このとき Task Wait QPS by Priority というメトリックにて、リソースコントロールがクエリの動作を制限していた形跡を確認しました。
https://github.com/tikv/tikv/issues/18939
この不具合を理解するために、TiKVにおけるリソースグループの動作を簡単に説明します。TiDBのリソースコントロールでは、リソースグループごとにRU(Request Unit)にもとづく流量制御と、優先度(HIGH/MEDIUM/LOW)に基づく実行制御が行われます。TiKV側では優先度ごとにタスクの実行キューとCPUクォータ(priority quota limiter)を持ち、CPU使用率が閾値を超える混雑時には、低い優先度のタスクに割り当てるCPU時間を絞ることで高い優先度のタスクの実行を確保する実装になっています。さらにこのクォータは固定値ではなく、実際の利用状況をもとに、優先度ごとの割当量を自動調整する仕組みになっていました。

今回は、この自動調整ロジックの問題により、実際には制限する必要がない場合でも、MEDIUM/LOW優先度に割り当てられるクォータが最小値まで絞り込まれていました。その結果、TiKV全体のCPUには十分な余裕があるにもかかわらず、Priority: MIDDLEで動作しているワークロードが待たされる、という事象が発生します。
この不具合に遭遇するまでは、デフォルトのワークロードをPriority: MIDDLE、負荷を隔離して制限すべきワークロードをPriority: LOW にて運用を行っており、Priority: HIGH は将来のために利用していなかったため、通常通り動作するならば、Priority: MIDDLEのクエリが制限を受ける理由はありませんでした。不具合はTiDB 8.5.5で自動調整そのものの無効化という形で改修されていますが、それまでのワークアラウンドとしては、このバグにヒットしないためには、Priority: HIGHを設定する、という対処をとりました。
リソースグループをご利用の方は、OLTP(Online Transaction Processing)トラフィックには、Priority: HIGHを割り当ててご利用ください。
リージョンサイズ (coprocessor.region-split-size) 調整
続いて、2つ目の取り組みであるリージョンサイズの調整を紹介します。前提として、リージョンとは、TiKVがデータを一定のキー範囲ごとに区切って管理・複製する単位であり、負荷分散や障害復旧の実施単位です。
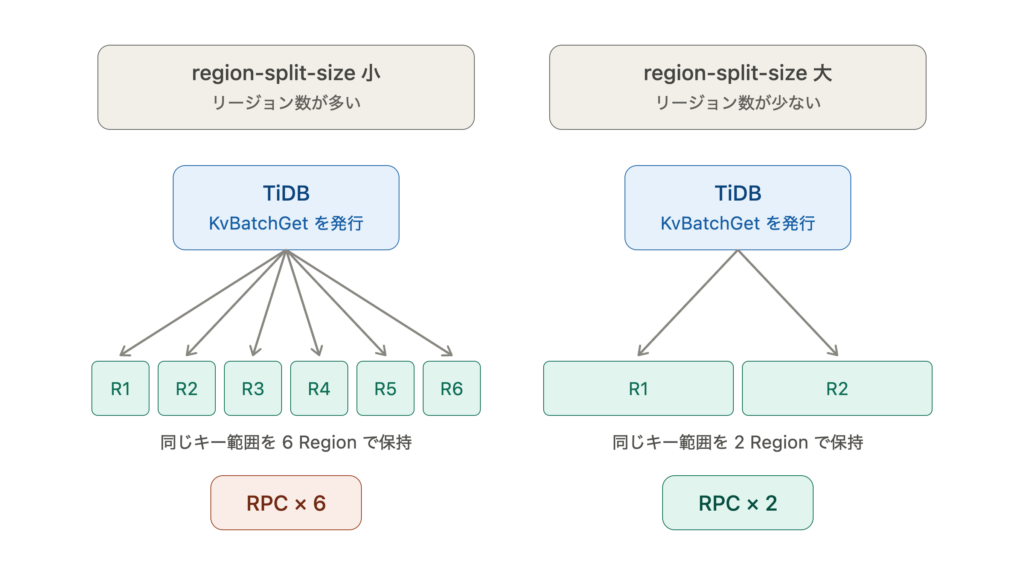
リージョン数を減らす(リージョンサイズを増やす)と、TiKVのKvBatchGet/Coprocessorといった取得処理のRPC(Remote Procedure Call)数が減り効率化されます。一方でリージョンサイズを増やすと、負荷分散がされにくくなったり、負荷分散のためにリージョンを移動する際の処理が大変になったり、というトレードオフが発生します。下記のドキュメントなどを確認し、調整を進めていく必要があります。本パラメータは、クラスタグローバルの設定値であり、基本的には特定のテーブルだけリージョンを小さくしたりする、ということはできません。下記の記事の後者の記事は、特に詳しい記載があるのでそれをよく参照してください。
https://docs.pingcap.com/tidb/stable/tune-region-performance/
https://www.pingcap.com/blog/understanding-raft-region-size-tidb-performance-recovery/
なお、リージョンサイズの目安である region-split-size のデフォルト値は、v8.4.0(LTS系列ではv8.5系)で96MiBから256MiBに変更されています(※)。
また、このregion-split-sizeに関連して、どのリージョンがどのサイズ以下になったら統合するか、といった付随するパラメータも存在し、これに対しても合わせて考慮が必要です。
本パラメータの調整により効果が期待できるケースとしては、大量のデータを保持しており、複数行のデータを一括取得するワークロードがある場合が挙げられます。逆に単一行の取得が多かったり、そもそもデータ量が少ない場合に効果は見込めません。
メルカリでregion-split-sizeを96MiBから256MiBに調整したタイミングでは、クラスタ全体でのリージョン数としては10%程度減少し、TiKVのCPU負荷ベースで最大約20パーセントの改善が見られた例がありました。
最新のデフォルト値より小さいサイズで運用している方は、この値の変更を積極的に検討するとよいと思います。
※ v8.5.0〜v8.5.2にはアップグレード時に実効値が意図せず256MiBへ切り替わる問題があり、v8.5.3で修正されています(tikv#18503)。
プランキャッシュ/インスタンスプランキャッシュの検討
3つ目の取り組みは、プランキャッシュの検討です。この章では、プランキャッシュとは何か、TiDBのプランキャッシュはどのような設定があるか、メルカリでどのように導入し効果はどうだったか、効果はどのように確認できるかについて説明します。キャッシュの効果はワークロード依存ですので、この記事を参考に設定の有効化を検討してみてください。
プランキャッシュとは
リレーショナルデータベースがSQLを実行するとき、内部では受け取ったSQL文字列の構文解析、参照先テーブルやインデックスの解決を経て、どのインデックスを使い、どの順序・アルゴリズムでテーブルを結合するかといった「実行計画」を統計情報にもとづいて選択し、そのうえで初めて実際のデータの読み書きを行います。この実行計画の選択(最適化)は、候補となる計画の列挙とコスト評価を伴うため、相応のCPUコストがかかる処理です。
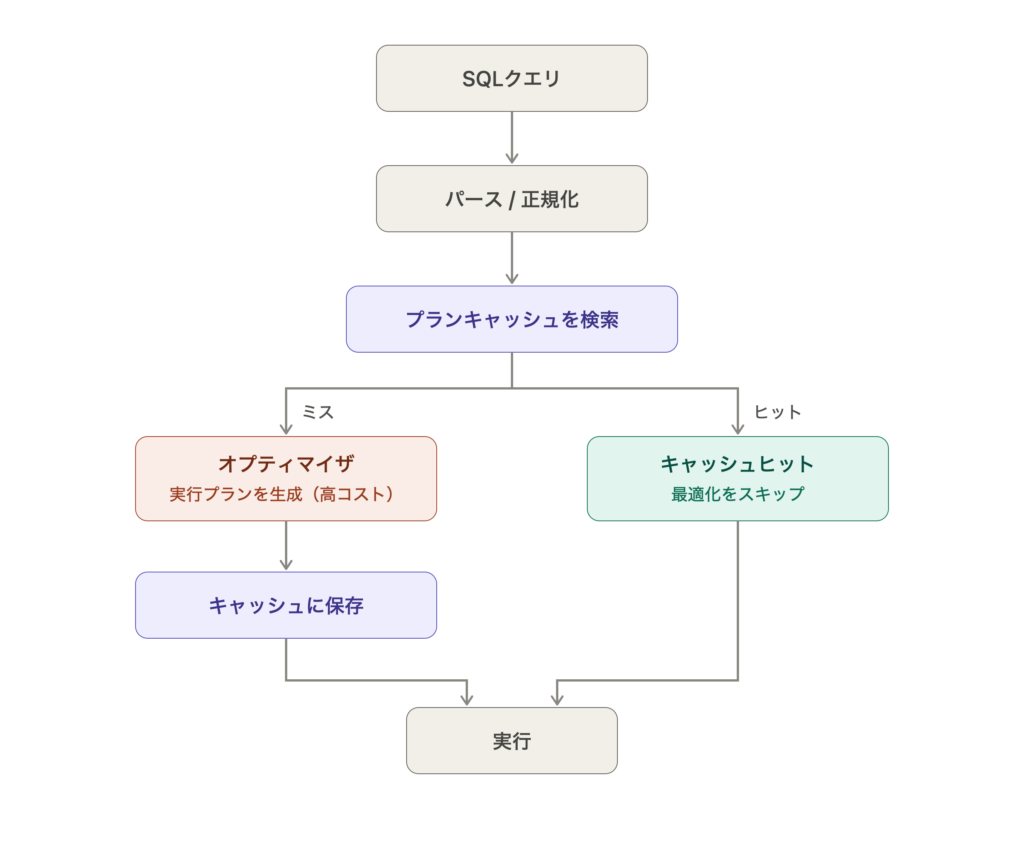
OLTPワークロードでは、パラメータの値だけが異なる同じ形のクエリが大量に実行されます。1回あたりの実行時間が短いクエリほど、処理全体に占める最適化コストの比率は相対的に大きくなります。そこで「同じ形のクエリに対して一度選択した実行計画を保存しておき、次回以降は最適化を省略して再利用する」という発想が自然に出てきます。これがプランキャッシュの基本的な考え方であり、多くのRDBMSが何らかの形でこの仕組みを実装しています。プランをキャッシュすることで実行プランの生成コストが抑えられる可能性がある一方で、キャッシュを検索したりあるいはキャッシュに保存したりという処理にもオーバーヘッドがあり、導入に効果があるかどうかを見極めて利用する必要があります。
TiDBにおけるプランキャッシュ
TiDBのプランキャッシュについて、知っておくべきは下記のようにまとめられます。
- プリペアードステートメントと、その他(ノンプリペアードステートメント)でキャッシュの扱いが異なる
- 従来(8.4より前)はキャッシュの単位がセッション単位だった
- 8.4からインスタンスプランキャッシュという、TiDBノードでプランキャッシュを共有する機能が利用可能になった
- セッション単位のキャッシュよりもメモリ効率よくキャッシュできますが、キャッシュの共有範囲はTiDB Cluster全体ではありません
- インスタンスプランキャッシュは、通常のプランキャッシュが有効である前提での追加機能
- プリペアードステートメントでない、通常のDML(Data Manipulation Language)に対するキャッシュは現状デフォルトオフである
ここまでは、TiDBの機能そのものについての一般的なまとめになります。ここから本機能の利用におけるメルカリでの事例について紹介します。
メルカリでのプランキャッシュの導入
メルカリでは順次移行切り替え済みのTiDBに対して、最初はプランキャッシュを有効にして運用してきました。これらのクラスターは8.1系から8.5系へバージョンアップをする機会がありました。この際にプランキャッシュのヒット率が大幅に低下するといったことを経験したり、また期待していたインスタンスプランキャッシュを一度有効化するものの、有効化によるオーバーヘッドの方が大きく設定を再度無効化するケースがありました。運用しているクラスタのワークロードにより、キャッシュヒット率は大きく異なり、記事執筆時点では1つのクラスタでのみプランキャッシュ/インスタンスプランキャッシュを有効化し、残りのクラスタでは無効化しています。
ヒット率が想定ほど伸びない要因の1つは、数値リテラルの扱いでした。non-prepared plan cacheでは、数値カラムに対して ‘123’ のような文字列リテラルで比較しているクエリはキャッシュの対象外となります。メルカリではアプリケーションの一部が数値を文字列として埋め込むクエリを発行しており、これがヒット率を下げる一因となっていました。
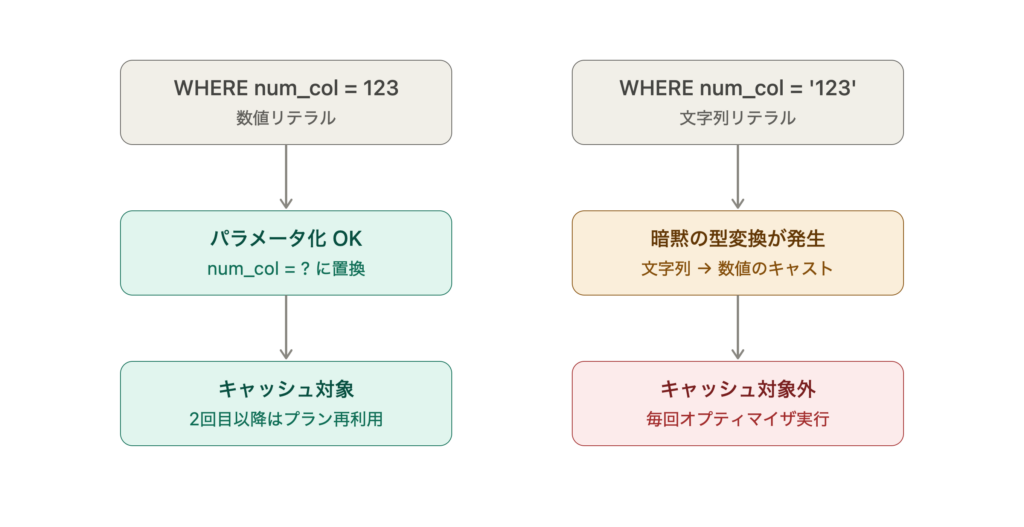
また、8.5系へのバージョンアップ後にヒット率が大幅に低下した事象には、オプティマイザのpredicate simplificationにOR条件の枝刈りを追加した下記の変更が関係していました。
https://github.com/pingcap/tidb/pull/56136
この枝刈りが発動したクエリは「OR predicate simplification is triggered」という理由でプランキャッシュの対象外となるため、OR条件を含む一部のクエリがバージョンアップを境にキャッシュされなくなりました。このような対象外の理由は、後述するSTATEMENTS_SUMMARYのPLAN_CACHE_UNQUALIFIED_LAST_REASONカラムでクエリごとに確認できます。
計画段階では下記のUsage Restrictionをよく確認し、実際のクエリにどの程度効果があるかを確認すると良いでしょう。
https://docs.pingcap.com/tidb/stable/sql-non-prepared-plan-cache/#usage-restrictions
プランキャッシュの効果の確認
プランキャッシュが実際に効いているか、あるいはなぜ効かないかは、TiDBの機能で確認できます。クエリ(digest)単位の集計は INFORMATION_SCHEMA.STATEMENTS_SUMMARY で確認でき、累計ヒット回数の PLAN_CACHE_HITS、直近実行がヒットしたかを示す PLAN_IN_CACHE に加えて、キャッシュ対象外と判定された回数(PLAN_CACHE_UNQUALIFIED)とその理由(PLAN_CACHE_UNQUALIFIED_LAST_REASON)も取得できます。ヒット率が想定より低い場合は、まずこの理由カラムを確認するのが近道です。
個別のクエリについては、EXPLAIN FORMAT='plan_cache' と SHOW WARNINGS で「そのクエリがnon-prepared plan cacheの対象になれるか、なれない場合の理由」を事前に診断できます(FORMAT指定のない通常のEXPLAINはキャッシュを利用しない仕様のため、診断にはこの形式が必要です)。また、直前に実行したクエリが実際にキャッシュを利用したかどうかは、セッション変数 last_plan_from_cache で確認できます。
-- 対象になれるかの事前診断(なれない場合は理由がwarningに出る)
EXPLAIN FORMAT='plan_cache' SELECT ...;
SHOW WARNINGS;
-- 直前の実行がキャッシュを利用したかの確認(1ならヒット)
SELECT @@last_plan_from_cache;
診断方法の詳細は下記のドキュメントを参照してください。
https://docs.pingcap.com/tidb/stable/sql-non-prepared-plan-cache/#diagnostics
In Memory Engineの活用
最後に、4つ目の取り組みを紹介します。メルカリでは一部のクエリでIn Memory Engine(IME)を活用しています。In Memory Engineは、更新や削除が頻繁なテーブルにおいて、読み取り時に大量のMVCC(Multi Version Concurrency Control)履歴バージョンを走査せざるを得なくなる問題を緩和する機能です。ホットデータをメモリにキャッシュして読み取りを高速化する機能ではない点に注意が必要です(その役割は従来からブロックキャッシュが担っています)。IMEは対象RegionのMVCCバージョンをメモリ上で管理し、ディスク上のGC(Garbage Collection)よりも積極的に古いバージョンを整理することで、クエリが読み飛ばす不要なバージョンの数そのものを削減します。このため効果が見込めるのは、MVCCバージョンが増えることにより読み取り性能を劣化させているワークロードに限られます。
私たちの環境はいわゆるキューのような使われ方をしているテーブルがあり、データの総量は小さい一方、非常に多くの挿入削除が発生するユースケースで、IME導入前に0.5〜1.5sのレイテンシだったクエリが0.1s程度に改善されました。
性能上一定の効果を確認できた一方、運用上の複雑さが増えたり、この機能の不具合で全体影響を受けるなど、ダウンサイドも多く経験しました。詳細な適用条件やチューニングは本記事の範囲を超えるため割愛しますが、導入は慎重な検証の上で行う必要があります。
まとめ
本記事では、リソースグループの不具合対応、リージョンサイズの調整、プランキャッシュの検討、In Memory Engineの導入という4つの取り組みを紹介しました。最後に、それぞれの経験から得られた教訓と推奨事項を整理します。
リソースグループについては、CPUクォータの自動調整の不具合により、Priority: MEDIUM以下のワークロードが想定外の制限を受ける可能性があります。改修が入ったTiDB 8.5.5より前のバージョンを利用している場合は、OLTPトラフィックにPriority: HIGHを割り当てることをおすすめします。
リージョンサイズについては、大量のデータを保持し、複数行を一括取得するワークロードで効果が期待できます。最新のデフォルト値(256MiB)より小さいサイズで運用している場合は、負荷分散とのトレードオフを理解した上で、変更を積極的に検討する価値があります。
プランキャッシュの効果はワークロードに強く依存し、バージョンアップを契機にヒット率が大きく変わることもあります。導入前にUsage Restrictionsを確認するだけでなく、STATEMENTS_SUMMARYなどを用いて効果を継続的に観測し、オーバーヘッドが効果を上回る場合には無効化する判断も必要です。
In Memory Engineは、MVCCバージョンの累積が読み取り性能を劣化させているワークロードに限って効果を発揮します。私たちの環境では大きなレイテンシ改善を得られた一方で運用上の複雑さも増えたため、導入は慎重な検証の上で判断することをおすすめします。
本記事の内容は、メルカリが2026年3月末までに行ってきた改善を3つに分けた2つ目の記事でした。残る1回の記事では、MySQL/TiDBにおけるインデックス非互換への対応についてお伝えします。ご期待ください。
おしらせ
最後に、現在メルカリでは、この記事の発行者の所属する DBREチーム の EM(Engineering Manager) および、IC(Individual Contributor)を募集しています。
この記事を読んで興味を持たれた方は、その旨をお知らせください。
詳しくは
- EM https://apply.workable.com/mercari/j/7AD4EF9218/
- IC https://apply.workable.com/mercari/j/ACD2689E9E/
をご覧ください。
また、メルカリにおけるTiDBやデータベース関連の取り組みについては、TiDB関連の記事一覧やデータベース関連の記事一覧もあわせてご覧ください。